 Hardware Ready Ready to Bench?
Unemployment Labs hat innerhalb der öffentlichen Gewichte des Modells DeepSeek-V4-Flash numerische Muster identifiziert, die auf die Verwendung von NVIDIA Blackwell GPUs während der Initialisierungsphase hindeuten. Das Labor war in der Lage, eine Hardware-Fingerprint aus den von den Entwicklern bereitgestellten Parametern zu rekonstruieren und eröffnet damit neue technische Aspekte in der Debatte über den chinesischen Zugang zu Beschleunigern, die den US-Exportkontrollen unterliegen.
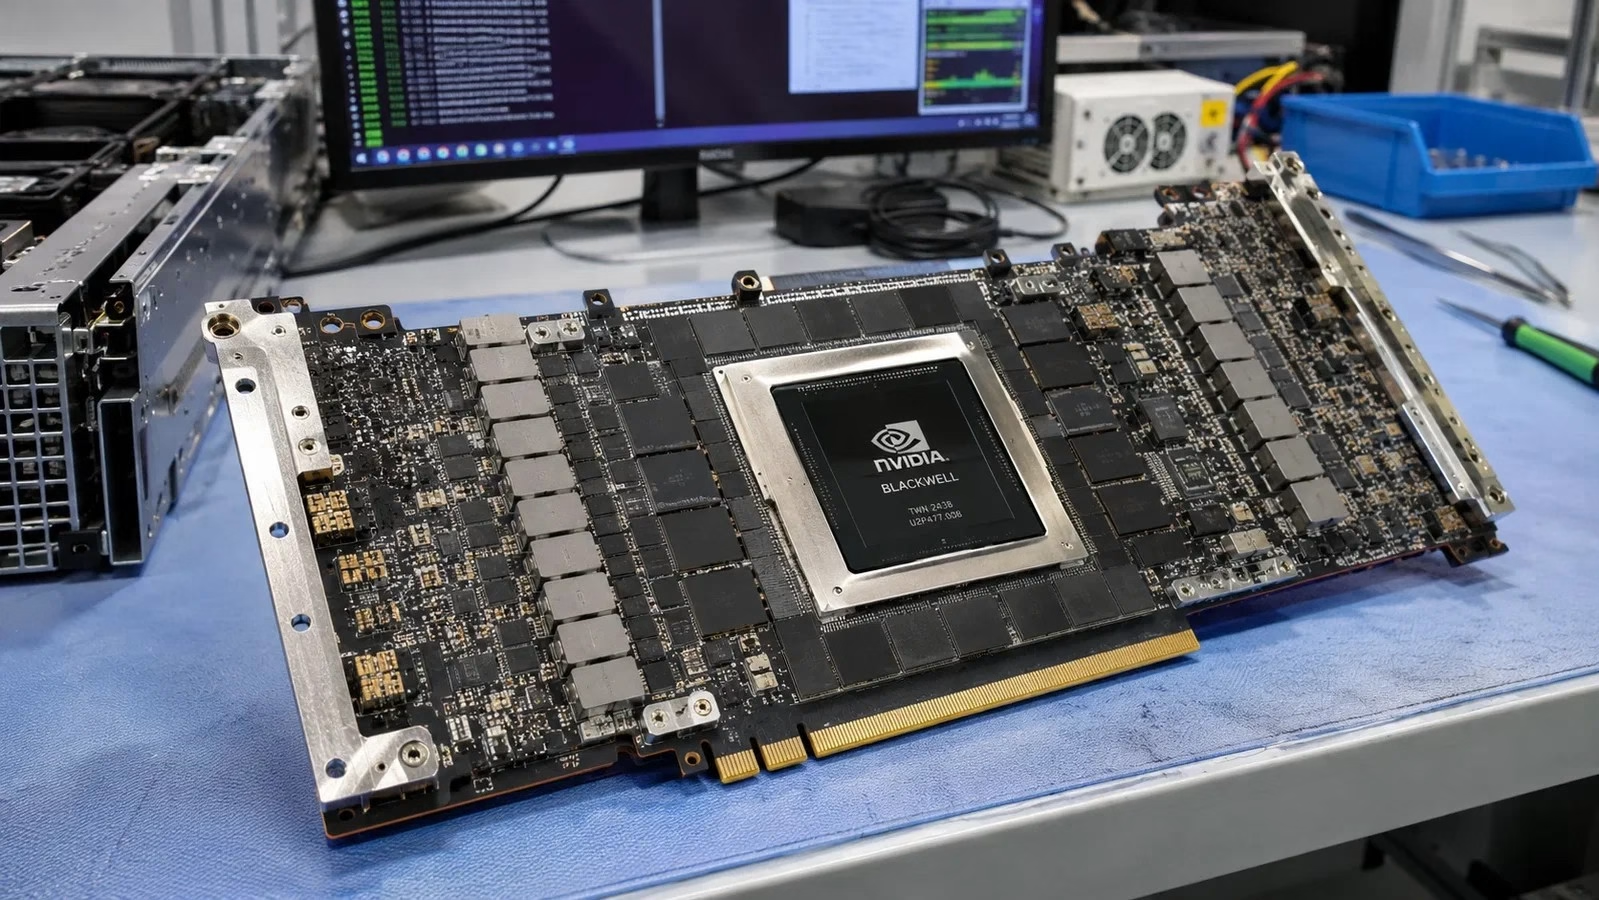
Die Analyse basiert auf den Gewichten des Modells, also den numerischen Werten, die es einem neuronalen Netz ermöglichen, eine Eingabe in eine Ausgabe zu verwandeln. Vor dem Training werden diese Werte über einen Pseudozufallsgenerator initialisiert, der von einem „Seed“, einem Startwert, gespeist wird. Während der Trainingsphase erfahren viele Parameter Änderungen, aber einige behalten Spuren der ursprünglichen Konfiguration bei und liefern damit nützliches Material für die forensische Analyse.
DeepSeek-V4-Flash: Warum das wichtig ist
Das Labor hat die wiederhergestellten Muster mit denen verglichen, die den Streaming Multiprocessors, den Recheneinheiten der NVIDIA-Beschleuniger, zugeordnet sind. Die verschiedenen Architekturen Hopper und Blackwell erzeugen erkennbare Anordnungen; durch die Rekonstruktion des Seeds und der Verarbeitungsstruktur ist es möglich, eine Übereinstimmung in den veröffentlichten Parametern zu suchen. Die öffentlichen Gewichte eines Modells können daher den Fingerprint der GPUs bewahren, die zur Initialisierung verwendet wurden, und bieten so eine neue Methode zur Hardware-Verifizierung.
Die Untersuchung erstreckt sich auch auf die Modelle DeepSeek-V4-Pro, MiniMax-M3, Kimi K3 und Ling-3.1-flash und betrifft die Unternehmen DeepSeek, MiniMax, Moonshot AI und Inclusion AI. Die aufgestellte Hypothese lautet, dass mehrere chinesische Entwickler Zugang zu Blackwell-Beschleunigern hatten, um ihre jeweiligen Modelle vorzubereiten, wobei Hardware-Fingerprints direkt aus den Gewichtsdateien wiederhergestellt werden konnten.
Schätzungen zu GPU-Clustern gehen von einer Nutzung von etwa 3.000 bis 4.500 Beschleunigern pro einzelner Trainingssitzung und einem kumulativen Bereich zwischen 7.000 und 22.000 Einheiten für die betrachteten Modelle aus. Diese Berechnung hängt von der Dauer der Sitzungen, der Nutzungseffizienz und der möglichen Infrastrukturteilung ab; der höhere Wert setzt voraus, dass die verschiedenen Modelle auf separaten Clustern trainiert wurden, anstatt dieselben Systeme zu unterschiedlichen Zeitpunkten zu nutzen.
Was sich ändert und welche Auswirkungen es hat
Es ist wichtig hervorzuheben, dass der identifizierte Fingerprint das Hardware betrifft, das für die Initialisierung verwendet wurde, und nicht beweist, dass dieselben GPUs den gesamten Trainingsprozess ausgeführt haben, noch wo sie installiert waren, wie der Zugang erhalten wurde oder ob die Exportkontrollen verletzt wurden. Unter den möglichen Zugangsarten wurde die ferne Nutzung von Clustern vermutet, wodurch Rechenkapazität über Infrastrukturen bereitgestellt wird, die physisch außerhalb Chinas lokalisiert sind.
Der Vergleich ergab unterschiedliche Ergebnisse bei DeepSeek-V4.1-Flash: Das Labor berichtet, keinen ähnlichen Fingerprint in der neuen Architektur gefunden zu haben. Auch verschiedene Qwen3-Modelle von Alibaba weisen eine andere Situation auf, da die Gewichte auf einem Standardprozessor (CPU) initialisiert wurden und somit einen anderen Verlauf hinterlassen als das im Rahmen der Untersuchung untersuchte GPU-Verfahren.
Quelle und weiterführende Informationen zu DeepSeek-V4-Flash: Originalartikel.
* Inhalt erstellt mit Unterstützung von KI-Systemen.