 Hardware Ready Ready to Bench?
Unemployment Labs ha individuato, all’interno dei pesi pubblici del modello DeepSeek-V4-Flash, schemi numerici che suggeriscono l’utilizzo di GPU NVIDIA Blackwell durante la fase di inizializzazione. Il laboratorio è stato in grado di ricostruire un’impronta dell’hardware a partire dai parametri distribuiti dagli sviluppatori, aprendo nuovi elementi tecnici nel dibattito sull’accesso cinese agli acceleratori soggetti ai controlli statunitensi sulle esportazioni.
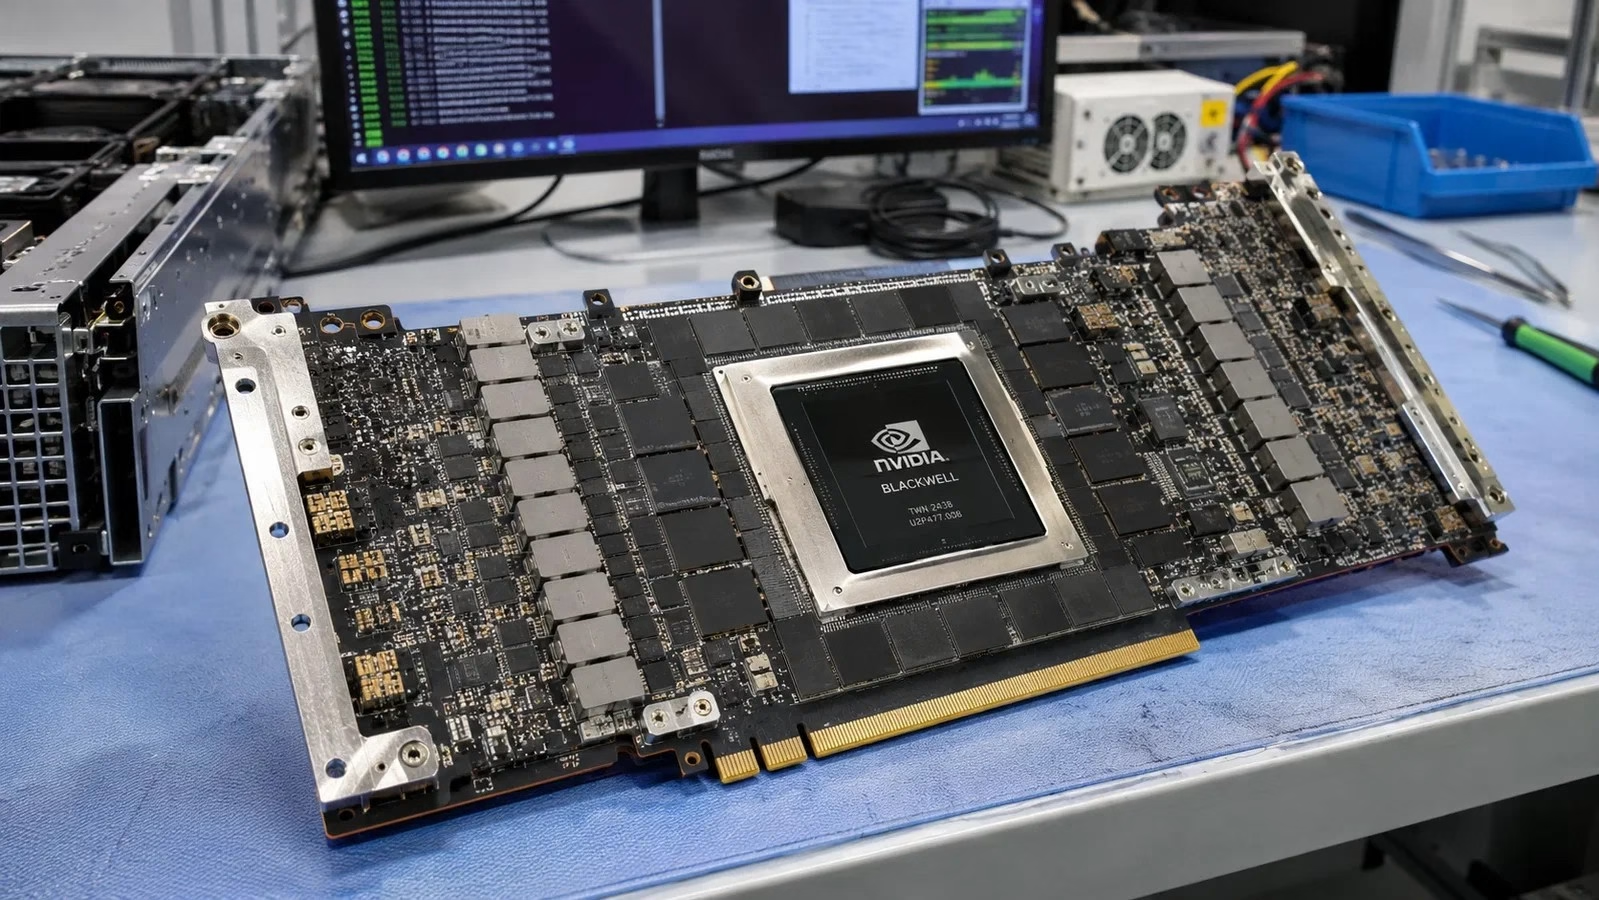
L’analisi si basa sui pesi del modello, ovvero i valori numerici che permettono ad una rete neurale di trasformare un input in un output. Prima dell’addestramento, questi valori vengono inizializzati tramite un generatore di numeri pseudocasuali alimentato da un “seed”, un valore di partenza. Durante la fase di training molti parametri subiscono modifiche, ma alcuni conservano tracce della configurazione iniziale, fornendo materiale utile per l’analisi forense.
DeepSeek-V4-Flash: perché è importante
Il laboratorio ha confrontato gli schemi recuperati con quelli associati agli streaming multiprocessor, i blocchi di calcolo degli acceleratori NVIDIA. Le diverse architetture Hopper e Blackwell producono disposizioni riconoscibili; ricostruendo il seed e la struttura di elaborazione è possibile ricercare una corrispondenza nei parametri pubblicati. I pesi pubblici di un modello possono quindi conservare l’impronta delle GPU utilizzate per inizializzarlo, offrendo un nuovo metodo per la verifica dell’hardware.
L’indagine si estende anche ai modelli DeepSeek-V4-Pro, MiniMax-M3, Kimi K3 e Ling-3.1-flash, coinvolgendo le aziende DeepSeek, MiniMax, Moonshot AI e Inclusion AI. L’ipotesi formulata è che diversi sviluppatori cinesi abbiano avuto accesso ad acceleratori Blackwell per preparare i rispettivi modelli, con impronte hardware recuperabili direttamente dai file dei pesi.
Le stime sui cluster di GPU ipotizzano un utilizzo di circa 3.000-4.500 acceleratori per singola sessione di addestramento e una forchetta cumulativa compresa tra 7.000 e 22.000 unità per i modelli presi in considerazione. Questo calcolo dipende dalla durata delle sessioni, dall’efficienza di utilizzo e dalla possibile condivisione dell’infrastruttura; il valore più alto presuppone che i diversi modelli siano stati addestrati su cluster separati, anziché utilizzando gli stessi sistemi in momenti differenti.
Cosa cambia e quali sono gli effetti
È importante sottolineare che l’impronta identificata riguarda l’hardware utilizzato per l’inizializzazione e non dimostra che le stesse GPU abbiano eseguito l’intero processo di addestramento, né dove fossero installate, come sia stato ottenuto l’accesso o se siano stati violati i controlli sulle esportazioni. Tra le possibili modalità di accesso è stata ipotizzata la fruizione remota di cluster, rendendo disponibile capacità di calcolo tramite infrastrutture fisicamente localizzate al di fuori della Cina.
Il confronto ha dato esiti differenti con DeepSeek-V4.1-Flash: il laboratorio riferisce di non aver trovato un’impronta analoga nella nuova architettura. Anche diversi modelli Qwen3 di Alibaba presentano una situazione diversa, in quanto i pesi sono stati inizializzati su un processore standard (CPU), lasciando quindi una traccia differente rispetto alla procedura su GPU esaminata nell’indagine.
Fonte e approfondimento su DeepSeek-V4-Flash: articolo originale.
* Contenuto realizzato con l'ausilio di sistemi di intelligenza artificiale.
 Ultra Starter Coreda 1.096 €
 Starter Coreda 1.317 €Power Boostda 2.161 €Hyper Strikeda 2.204 €
 Extremeda 3.655 €
HWReady Studio
Contenuti creati per te con l'intelligenza artificiale
Reel, spot e foto per la tua attività.
Scopri lo studio