 Hardware Ready Ready to Bench?
Lo sviluppatore Zagitta ha creato GPU Unlock, un progetto open source che rimuove una limitazione nel calcolo dei Tensor Core delle schede GeForce RTX 30. I benchmark pubblicati mostrano un quasi raddoppio del throughput, mentre i primi test di generazione immagini indicano un miglioramento fino al 58,6%.
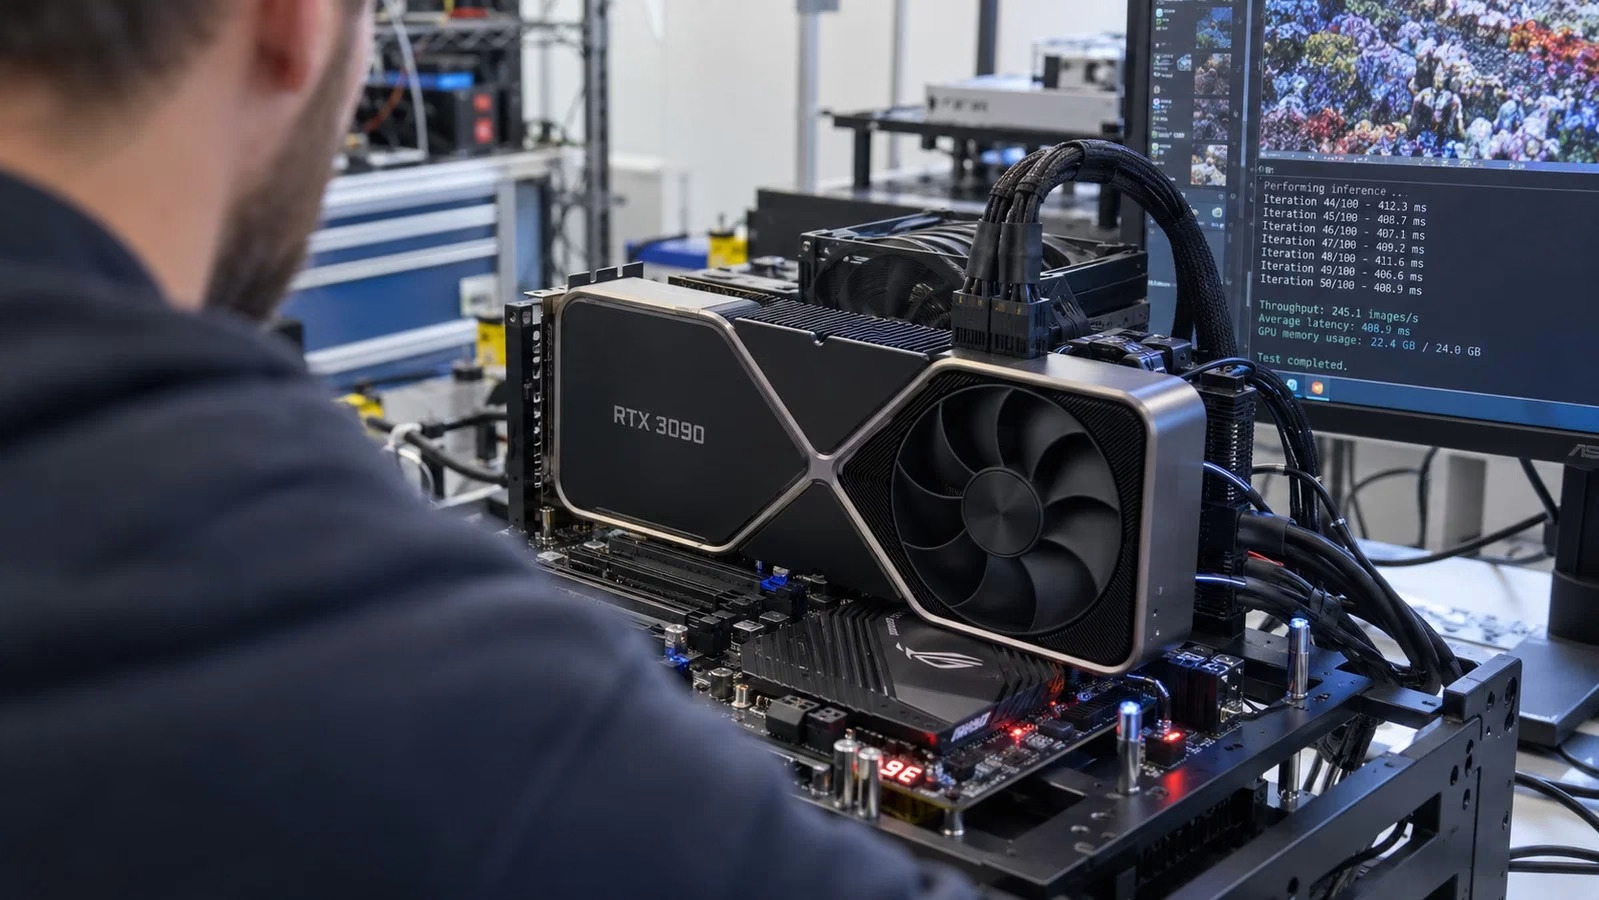
Questo incremento viene ottenuto su GPU Ampere già esistenti, senza richiedere modifiche ai driver NVIDIA o flash permanenti del VBIOS. Il progetto interviene sulla frequenza di emissione delle istruzioni Tensor Core per operazioni FP16/BF16 con accumulo in FP32.
GPU Unlock: perché è importante
Sulle schede Ampere consumer, queste operazioni vengono eseguite a un ritmo inferiore rispetto alle controparti professionali. Lo sblocco modifica i selettori hardware che regolano questo comportamento, consentendo alla GPU di sfruttare una capacità di calcolo già presente nel silicio.
La versione originale utilizza un modulo kernel Linux eseguito prima del caricamento del driver grafico. Riprende tecniche sviluppate per le schede NVIDIA CMP destinate al mining, modifica i selettori ed esegue un Function Level Reset, lasciando poi inizializzare la GPU con il driver standard. Questo meccanismo evita di dover riapplicare patch al driver dopo ogni aggiornamento; il supporto dichiarato include i chip GA102, GA103, GA104 e GA106.
Le RTX 30 possono quindi recuperare capacità di calcolo già presente nei Tensor Core, ma l’effettivo guadagno nell’AI dipende dalle operazioni eseguite dal modello. Nei test di moltiplicazione matriciale, una RTX 3090 Ti con limite di potenza a 450 W passa da circa 87,5 a 157 TFLOPS in BF16.
Un utente di RTX 3080 Ti ha riportato un incremento da 71,59 a 113,98 TFLOPS in BF16 e da 35,65 a 65,28 TFLOPS in TF32, con un limite di 315 W. Su una RTX 3080 da 10 GB, mantenuta ai 320 W originali, il throughput FP16/BF16 sale da circa 65 a 110–113 TFLOPS.
Cosa cambia e quali sono gli effetti
Le prove con ComfyUI mostrano come questo vantaggio sintetico si traduca nelle applicazioni. Su RTX 3090 Ti, un test della community registra un throughput superiore del 58,6% con MOSS-Image SFT BF16, del 57,2% con Qwen-Image 2.1 Turbo BF16 e del 56,1% con Z-Image Turbo BF16. La configurazione MOSS-Image SFT INT8 guadagna invece lo 0,3%; l’autore della prova riferisce inoltre immagini decodificate identiche tra configurazione standard e sbloccata.
Le applicazioni locali di AI sulle Ampere comprendono già esperimenti per insegnare a un’AI a giocare a Pokémon Red, ma nell’inferenza LLM il comportamento cambia anche all’interno delle fasi dello stesso lavoro. Un rapporto di compatibilità su RTX 3090 indica un miglioramento del 33% nell’elaborazione dei prompt con vLLM, mentre la generazione dei token rimane praticamente invariata: il decoding dei modelli linguistici è spesso vincolato dalla banda della memoria.
È comparsa anche un’implementazione sperimentale per Windows basata su UEFI, il cui sviluppatore documenta uno sblocco riuscito su RTX 3090 con un aumento del throughput BF16 di circa l’82,5%. I risultati dipendono però dalla scheda e dalle istruzioni utilizzate dal carico, e al momento manca una dimostrazione convincente di benefici nei giochi o nei tempi di esecuzione del DLSS.
Fonte e approfondimento su GPU Unlock: articolo originale.
* Contenuto realizzato con l'ausilio di sistemi di intelligenza artificiale.
 Ultra Starter Coreda 1.043 €
 Starter Coreda 1.256 €Power Boostda 2.011 €Hyper Strikeda 2.025 €
 Extremeda 3.418 €
HWReady Studio
Contenuti creati per te con l'intelligenza artificiale
Reel, spot e foto per la tua attività.
Scopri lo studio